IKnowWhatYouSaid 精读:从 CPU 缓存里读出本地 LLM 的输入与输出
把 LLM 部署到本地并不等于对话内容留在本地——同一台机器上一个没有特权的普通应用,只要盯住 CPU 缓存的访问模式和自回归解码的时序,就能把这次推理的输入与输出文本还原出来。
论文:I Know What You Said: Unveiling Hardware Cache Side-Channels in Local Large Language Model Inference(USENIX Security 2025)
作者:Zibo Gao、Junjie Hu、Feng Guo、Yixin Zhang、Yinglong Han、Siyuan Liu、Haiyang Li、Zhiqiang Lv(中国科学院信息工程研究所、中国科学院大学网络空间安全学院)
本地部署 LLM 的出发点是把数据留在自己机器上:不发给第三方 API,隐私敏感的内容不出门。这篇论文指出的是另一条路径——机器内部还有一条不属于软件层的泄漏通道。token embedding 查表时的访存模式泄漏了 token 的值,解码阶段每个 token 的时间点泄漏了 token 的顺序,两者都落在硬件缓存上。攻击者不与 LLM 进程交互,也不需要任何特权,用一个普通应用在后台记录缓存访问即可。
📚 基本概念速读
| 名称 | 定义 | 记忆点 |
|---|---|---|
| Token embedding | 把 token id 映射成稠密向量的操作 | 泄漏源头:查了哪一行就暴露了哪个 token |
| Embedding table | 形状为词表大小 × 向量维度的参数矩阵 | 攻击者只需知道它在模型文件里的偏移 |
| Prefill | 一次吃完所有输入 token、并行计算的阶段 | 缓存命中事件密集,切分靠它 |
| Decode | 自回归逐 token 生成的阶段 | 一次一个 token,时序规律 |
| TPOT | Time Per Output Token,生成一个 token 的耗时 | 决定时序信号的主频 |
| flush+reload | 共享内存下的缓存侧信道原语 | 探针精度到缓存行,能分辨 embedding table 的每一行 |
| Prefetcher(预取器) | CPU 里猜「你接下来要读哪儿」、提前把数据搬进缓存的硬件部件,AoP(Array-of-Pointers)是其中专门解引用指针数组的一种 | 攻击的对手:会替受害者把行摸热,制造假阳性 |
| Cache trace | 攻击者采到的 时间 × 地址 延迟矩阵 | 攻击的全部原始素材 |
| False positive / negative | 多检(没访问却报命中)/ 漏检(访问了没报) | 噪声的两个来源 |
| PSD | Power Spectral Density,功率谱密度 | 用来看 decode 阶段时序信号的周期性 |
| zero-copy 加载 | 框架用 mmap 直接映射模型文件、省掉一次拷贝 | 顺手给了攻击者一份共享内存 |
| ASR | Attack Success Rate,本论文定义为语义相似度大于 0.77 的样本比例 | 阈值来自 100 人的人工投票 |
🎬 起点:模型留在本地,对话为什么还是漏了
先看场景。用户在自己的 PC 上跑一个本地 LLM:llama.cpp、Ollama、GPT4All 这类框架都算,模型是常见的小尺寸量化版本,日常用来问私事、写敏感邮件。机器上还装了别的东西,其中一个是攻击者放出来的普通应用——它可能就挂在应用商店里,行为完全合法。
论文的威胁模型建立在这三条假设上:
- 攻击者没有特权:只是一个能与受害者同时运行的进程,操作系统隔离照常生效,不改 LLM 用的任何库,不与 LLM 进程通信;
- 攻击者只需要几条常规能力:能执行代码,能以只读方式打开模型文件并
mmap(内存映射:把一个文件映射进进程的地址空间,之后像读内存一样读它,数据由内核按页从磁盘带进来),拿不到就退而用操作系统的页去重拿到共享内存,还能执行clflush清缓存; - 攻击者不需要知道模型结构,也不需要框架的源码或二进制,但能根据公开的模型文件格式(safetensors、pickle)算出 embedding table 的地址偏移。
1 | ┌────────────────────────┐ ┌────────────────────────┐ |
图里最关键的一点是不对称:进程隔离挡住了直接读内存,但挡不住共享的缓存。这张表在物理内存里只有一份,两个进程各自的页表都指向它,缓存行的命中与否对所有核都是同一个事实。
🔑 前提:embedding 查表跑在 CPU 上
这条假设决定了攻击能不能成立,论文也专门做了说明:token embedding 这一步在 CPU 上执行,模型其余各层可以放在任何设备上(包括 GPU)。
理由是成本。本地部署里 CPU 做 embedding 最划算,Intel 的 CPU 推理白皮书、Meta 的 Llama Everywhere、Numenta 以及各个社区框架都把 embedding 留在 CPU,只把后面的矩阵计算丢给 GPU。所以一份跑在 RTX 3060 上的 llama.cpp,它的 embedding 查找依然发生在 CPU 上。
反过来说,一旦 embedding 也被放到 GPU 上查表,CPU 的缓存攻击就看不到了:离散 GPU 的缓存与 CPU 缓存不保持一致。论文的框架评估里唯一失败的 GPU 配置,正是这个原因(见后文)。
🔍 两条泄漏源:token 值与时序
🎯 泄漏一:查表模式暴露 token 值
LLM 的输入输出都是 token 序列,模型需要先把每个 token 变成稠密向量才能计算,这一步叫 token embedding。写成矩阵形式,就是对 one-hot 编码做一次线性投影:
1 | E = W x |
one-hot 是稀疏的,所以实现上没人真的做矩阵乘法,而是退化成一次查表:取 W 的第 ti 行。而查表是访存行为,访存会经过缓存:
1 | x = [0, 0, 1, 0, ..., 0] ← one-hot,index i 是当前 token |
第 i 行被载入缓存这件事,在缓存侧信道上可以直接观察(用什么手段观察,见后文「采集」一节的 flush+reload)。于是观察到哪一行命中,就反推出此刻处理的是哪个 token。
还有一步放大:LLM 是自回归的,新生成的 token 会被重新喂回模型,再次经过 embedding。所以这一条泄漏同时覆盖输入 token 和输出 token——用户问了什么、模型答了什么,都会在同一个表上留下痕迹。
⏱️ 泄漏二:自回归时序暴露 token 顺序
知道有哪些 token 还不够,还需要知道它们的顺序。论文在时间维度上另找了一处泄漏:LLM 推理分 prefill 与 decode 两个阶段,prefill 先把全部输入 token 算完,decode 再一个 token 一个 token 地往外吐。这些阶段天然串行,decode 要等 prefill 结束,第 i+1 个 decode 要等第 i 个 token 出来。
于是时间轴上能得到两件事:
- 输入与输出的分界:prefill 结束的时间点,就是模型开始回答的时间点;
- 输出 token 的顺序:每个 decode 阶段对应一个 token,先后顺序就是文本顺序。
🚧 两个真正的难题
论文自己列了两条挑战,后面所有设计都是围着它们转:
| 挑战 | 现象 | 后果 |
|---|---|---|
| C1 噪声 | 缓存侧信道有假阳性与假阴性 | token 列表里混进随机 token、丢掉真 token |
| C2 输入顺序被打乱 | prefill 把输入 token 批量并行计算,embedding 操作在时间轴上交叉重叠 | 输入 token 被还原成一个无序集合,顺序丢了 |
C1 的解法是引入一个微调过的 LLM 去噪,C2 的解法是利用输入与输出的上下文关联给无序 token 排序。这两个模型在论文里叫 LLMA 与 LLMB。
🧩 攻击总览:五步把缓存轨迹变成文本
1 | 1. Spy 采集 cache trace |
前 3 步是信号处理,后 2 步是模型推理。这种分工也解释了论文的方法论取向:硬件侧只负责拿到质量不高的观测,语义层的补全交给自然语言模型去做。
🛠️ 采集:怎么录下每一行的访存
📐 先算出目标地址
探针需要一个一个具体的地址去擦、去测,所以第一步是把「32768 个 token 各自对应哪一行、那一行落在哪个地址」先算出来。
先看 embedding table 在内存里长什么样。它是一个 |V| × D
的矩阵:|V| 是词表大小(Llama 2 是 32768),D
是向量维度(4096),每个元素 b 字节(FP16 下是 2
字节):
1 | ←———— 一行 = D 个元素 = D·b 字节 ————→ |
这块表在模型文件里有一个固定偏移 p2——safetensors、pickle
的文件格式都是公开的,照着文档就能算出来;模型文件被 mmap
进地址空间之后,又有一个起始地址 p1。两个数一拼,第
i 行的起始地址就得到了:
1 | 一行占 D·b 字节,前面还有 i 行 -> 前面总共占掉 i·D·b 字节 |
范围拿到之后,每行只需要挑一个地址做探针,理由分三步:
- 缓存的最小单位是缓存行(x86 上是 64 字节),而探针测的其实是「某个地址所在的那个缓存行,此刻在不在缓存里」;
- 一行是
D·b = 4096 × 2 = 8192字节(8 KB),刚好跨8192 ÷ 64 = 128个缓存行; - 模型查表时取的是整个 D 维向量(后面的层要拿它参与计算),所以这 128 个缓存行会被一起载入缓存。
既然这 128 个缓存行同进同出,盯住其中任意一个就够——这一个变热,就等价于「第 i 行被访问过」。要是 128 个都盯,探针要扫的地址数凭空翻 128 倍,纯属浪费。
于是攻击者既不需要模型、也不需要框架的任何秘密——只要文件格式是公开的,这 32768 个地址就能自己算出来。
🤝 共享内存从哪来
缓存攻击要求攻击者与受害者共享物理内存。论文用了两条互相替代的路径:
- 首选 mmap:现在主流的 LLM 框架都用 zero-copy
方式加载模型,直接把模型文件映射进地址空间、按需分页。攻击者对同一个模型文件调一次
mmap,两个进程就会因为 page cache 落在同一批物理页上,共享内存是白送的,不需要页去重; - 备选页去重:万一某些框架不支持 zero-copy,就用操作系统提供的 page deduplication(KSM 一类机制)拿到共享页。
这里的因果关系值得留意:zero-copy 是一个性能优化,它顺手把攻击面也一起送了出去。论文后面给出的对策之一,正是把它关掉。
📏 怎么测一行:flush+reload 探针
前面两步解决了「监视哪些地址」和「怎么拿到那些内存」,还差最核心的一环:怎么知道某一行在某个时刻有没有被访问。
论文用的原语是 flush+reload,机制一句话:擦干净,等一会儿,再摸一下看快慢。
下面用 A
表示一个探针地址,也就是上一节算出来的 32768
个地址里的某一个(它代表第 i 行):
1 | clflush(A) ① 把地址 A 所在的那条缓存行,从各级缓存里踢出去 |
要害在 ① 给出的干净初始状态。这条缓存行被踢出去之后,能重新回到缓存里的原因只有两个:攻击者自己 ③ 的那次读,或者受害者在这段时间里访问了它。而 ③ 是踢出去之后的第一次读,必然未命中,所以剩下来就只有一种可能——reload 的耗时本身就是答案:快,就说明受害者刚才碰过这条缓存行。
(注意「只有两个原因」是原始 flush+reload 的前提,而预取器恰恰会打破它——它不是受害者,却会替你把这条缓存行搬回来。下一节讲的就是这件事。)
一轮完整扫描,就是把这个动作在全部 32768 个地址上过一遍:
1 | for v in 0 .. |V|-1: clflush(A[v]) // ① 一次全擦干净 |
这里有个前提要先说清楚:攻击者与受害者之间没有任何约定——他不知道这次推理什么时候开始、什么时候结束,论文把这称为异步攻击场景。所以探针不是”被推理触发”的,而是从头到尾一刻不停地扫,事后才回到轨迹里去切段(见后文)。
实现上还有两个纵深:探针线程被拆成 15
个分区(partition),各自独立扫自己那一份地址(每轮按伪随机顺序,s = t*m + (v*167 + 13) % n)——分片把每轮的墙钟时间压到约
1/15,这才撑得起”远快于出
token”;另外每个内存页只取中间地址做探针,进一步躲开相邻页被顺带预取的可能。
有两个细节必须处理,它们也正是下一节的由来:
- ③ 的访问顺序必须打乱:如果老老实实按 0、1、2 往下读,CPU 的预取器(下一节的主角)就会猜出攻击者要读什么,提前把这些行搬进缓存,于是每个地址看起来都命中——全是假阳性;
- ② 的窗口不能随便拉长:太短则受害者的推理还没跑到,太长则不同 token 的事件会混在同一轮里;更麻烦的是,已经命中的缓存行会被后续的访问挤出去,变成漏检。
所以「打乱顺序」不是锦上添花,而是标准实现的一部分——而恰恰是这个标准做法,在 Raptor Lake 上撞了墙。
⚠️ 硬件预取器把标准 flush+reload 打趴了
论文里值得一提的一段,是它报告了一个负面结果。
按标准做法实现 flush+reload 之后,攻击在 Intel 的 Raptor Lake(13 代酷睿,即本文实验平台的 i9-13900K)上几乎完全失效:监视 32768 个地址(Llama 2 的词表大小)时平均每秒 5,612,394 次假阳性,精度接近零。
原因是硬件里的预取器——CPU 里专猜「你接下来要读哪儿」、提前把数据搬进缓存的小助手。它把这条攻击打趴用了两步。
第一步:它替受害者把格子摸热了。 上一节的判定逻辑是「我擦干净之后,这条缓存行还是热的,就说明有人动过」。小助手一猜中,就抢在间谍前面把格子摸热了,间谍摸到热便当成「受害者访问过」——全是假阳性。打比方:想知道昨晚有没有人到过门口,就在地上撒面粉看脚印;结果保安半夜巡逻路过留下脚印,你一看就断定「有人来过」。更糟的是这保安是间谍自己请来的:访问越有规律,它猜得越准。所以前人的标准对策是打乱访问顺序。
第二步:打乱顺序要先有清单,而这份清单正好喂给了另一个小助手。 要乱序访问,代码里就得先有一份「32768 个目标地址」的数组,才能随便挑着读:
1 | ptr_array[] = { A0, A1, ..., A|V|-1 } // 数组元素 = 地址本身 |
CPU 里的预取器不止一个。间谍用乱序防住了猜步长的那位,却撞上
AoP(Array-of-Pointers
prefetcher),它的专长恰好是:看见一张表里装的全是地址,就把这些地址指向的缓存行一次全搬回来。它不看访问顺序,只看数组内容像不像地址——而
ptr_array 里装的正好是 32768 个地址。于是每轮刚
clflush 完,AoP
就替他把目标全部预取回缓存,几乎每个地址看起来都命中,精度归零。
绕过办法很朴素,正好卡在预取器的语义上:别让数组里再出现地址。
1 | 原来:ptr_array[] = { A0, A1, ..., A|V|-1 } |
数组里只存偏移(每个目标地址减去最小地址),访问时再把偏移加回去还原真实地址。关键在于:预取器只会照抄内存里看得见的值——它把数组里的偏移当成指针去解引用,只会摸到进程低地址那一片无关内存;而真正的基准
min
只活在间谍自己的寄存器里,预取器看不见。地址这个信息于是从「内存里的数据」挪进了「间谍自己的计算」,它就无从下手了。
其余的预取器沿用前人的做法对付:探针地址不落在相邻页上、访问顺序随机化。
🖥️ 缓存轨迹长什么样
采集结果是矩阵 o:L 个时间点 × |V| 个目标地址的访存延迟,另外用
rdtsc 记下每个时间点的物理时间戳。论文用一幅热力图(Figure
3)展示它:颜色越深表示该行越可能被访问。在这样一张图里,prefill
表现为一条竖直的密集色带,decode 表现为稀疏的散点。
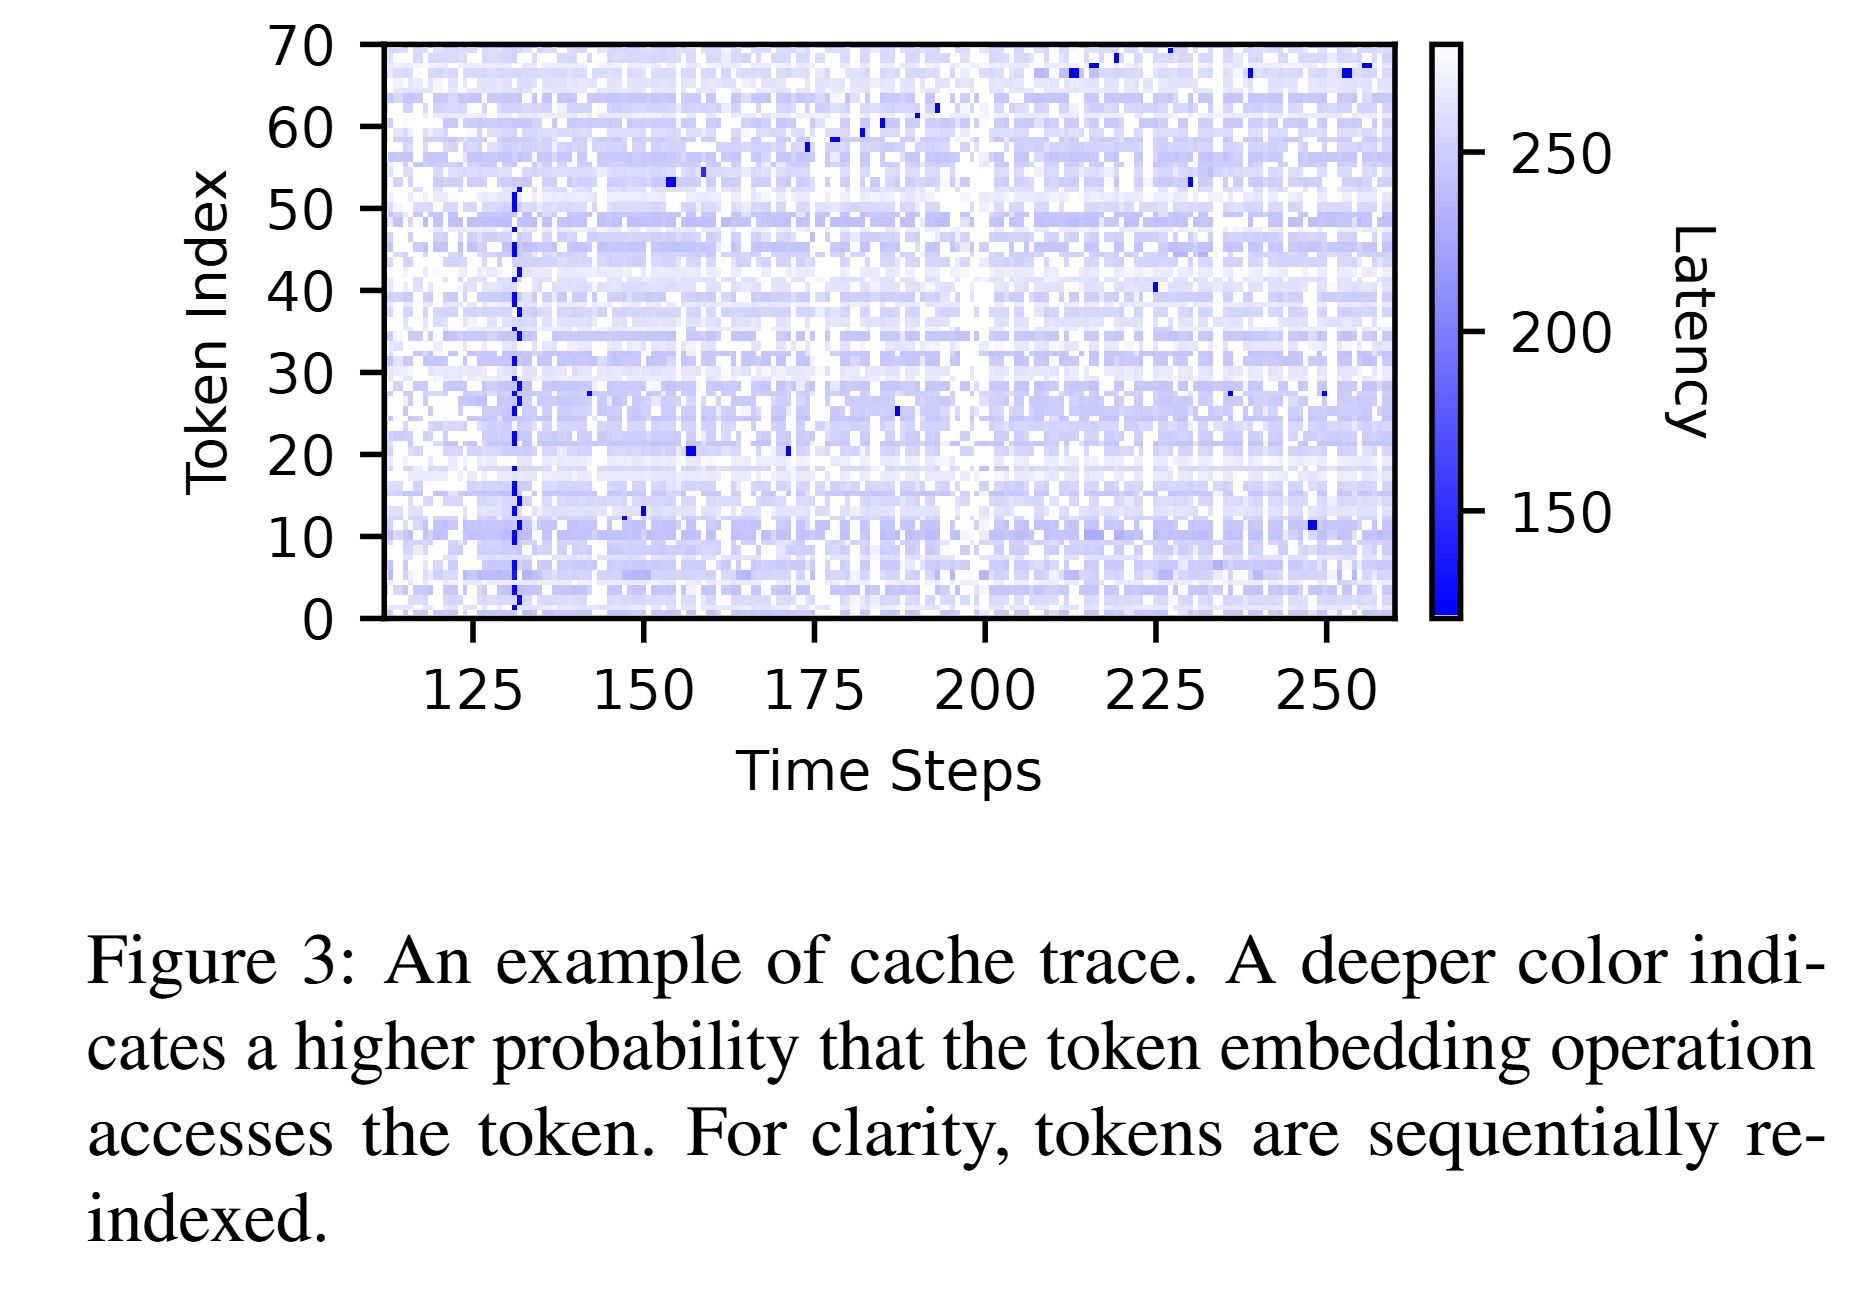
从「延迟」到「命中」还差最后一步判定:延迟低于阈值 α2 记为命中,α2 由缓存微基准测试得出。判定之后的每一个命中就是一个「命中事件」,后面切段与映射全都建立在它上面。
✂️ 切段与映射:prefill 在哪,decode 在哪
攻击者不知道推理是什么时候开始的(就是前面说的异步场景),所以起点只能从轨迹里自己找。论文用一个模式匹配算法定位两个阶段的起点:
- prefill 起点:从某个时间点起,连续不少于 K 个事件的时间间隔都小于阈值 α1。输入是批量并行计算的,命中事件会异常密集地挤在一小段时间里;
- decode 起点:在 prefill 之后,出现至少一个间隔大于 α1 的事件。decode 一次只产出一个 token,事件稀疏得多。
论文的取值是 K = 4(允许的最小输入 token 数)与 α1 = 10⁻³(按上下文即 1 毫秒,不大于一次前向传播的最小耗时)。
切完之后,轨迹被映射成三样东西:
| 输出 | 含义 | 怎么得到 |
|---|---|---|
| KD | 有序 token 列表(decode 段) | 每个时间点命中哪些地址,查表反查成 token 文本,去掉空集 |
| TD | 时序信号(decode 段) | 每个命中事件对应的时间戳序列 |
| KP | 无序 token 集合(prefill 段) | 整个 prefill 段命中的地址并起来反查 |
这三样里,KD 与 TD
是同一批事件的两种属性,按下标一一对齐:KD[k] 是第
k 个命中反查出来的 token,TD[k]
就是它发生的时刻。也就是说「内容」和「时刻」同源,后面的去噪才能用「时间上对不对」去纠正「token
对不对」。KP 与它们无关,它来自 prefill 段,只有一个没有顺序的集合。
到这里,硬件侧的工作就结束了,剩下的是从一个很脏的 token 列表和一条带噪的时间戳序列里把文本拼回来。
🧠 去噪与还原输出:LLMA 与时序信号
上一节交出来的是一对脏数据:一份可能多词、可能少词的有序 token 列表 KD,和一条与它逐项对齐的时间戳序列 TD;这一节要把它们还原成干净的输出文本。要做的判断说白了只有三选一:补一个 token、删一个 token、不动。
两类污染各有来历:「多词」来自多检——不是 embedding 引起的访存被误判成命中,反查出来就是一个随机 token;「少词」来自漏检——真的 embedding 命中被漏判了。所以这一节只做两步:先量出「正常间隔多长」,再看每个间隔偏了多少,剩下的「动哪个 token、补什么词」交给语言模型。
📈 只要一件事:真命中的间隔是固定的
去噪的依据其实只有一条:decode 是「一个萝卜一个坑」的——每生成一个 token 就查一次 embedding,命中事件也就跟着 token 的节拍一个挨一个落下来,相邻两次真命中之间的间隔基本恒定。这个间隔就是 TPOT(生成一个 token 的耗时),论文的环境里约 10 毫秒。
论文为这个前提给的理由是:LLM 的前向传播是数据流驱动的,走的是规整的流水线(不像控制流驱动的程序那样路径不定),所以每次生成 token 可以近似看成一个周期性事件。
于是判断噪声的办法很朴素:看间隔。正常间隔是那个固定值,凡是「不对劲」的间隔,附近就有噪声。后面会看到,间隔只有两种不对法。
那这个固定值从哪儿来?论文不假设攻击者知道受害者机器的
TPOT,而是「从数据里自己量」:把时间戳序列转到频域,有节拍就会表现为基频
f0 上的尖峰,再用 SWIPE’ 把 f0 读出来,T = 1/f0
就是那个固定间隔。(看不懂频域不影响往下读,这一步的作用就是「自动量一遍正常间隔是多少」。)
1 | PSD |
顺带它还证明了一件事:这串命中里确实有稳定的节拍,不是一片随机(如果全是随机命中,频谱就是平的、没有尖峰)。但它回答不了「第几次命中是噪声」——频域是一次整体统计,指不到具体某一个点。要指到具体位置,只能回到时间轴上逐个看间隔,也就是下一小节。
(论文的预期是在 100Hz 处出现峰,也就是每 10 毫秒一个 token;原文这一句把 TPOT 写成约 10 microseconds,按 100Hz 反推单位应是 ms,见文末口径一节。)
📉 一阶差分:每个间隔除以 T,看是几倍
要指到具体位置,只剩这一步:把相邻两个命中的时间差除以 T,也就是问「这一段相当于几个正常间隔」。
1 | TD_hat[k] = f0 * ( TD[k] - TD[k-1] ) // 等价于 (TD[k] - TD[k-1]) / T,其中 T = 1/f0 |
正常情况下这个读数就是 1——因为除的就是正常间隔本身。所以这里不需要再记任何绝对时间,只看它离 1 有多远;除以 T 的意义也在这儿:把毫秒换成「几倍正常间隔」,换台机器跑也照样读。图上的纵轴标的就是这个倍数,不是时间:
1 | normalized first-order difference |
偏离这个基准的两类异常正好对应两类噪声,用一个具体例子看最清楚:设
TPOT 恰好是 10 ms,真命中落在 0, 10, 20, 30, 40, 50
ms,依次对应输出 the cat sat on the mat 这 6 个
token。(归一化值的个数 = 命中个数 −
1,所以下面三行的长度本来就不一样。)
| 情形 | 观测到的命中时刻(ms) | 相邻间隔 → 归一化(÷T) | KD 里发生了什么 |
|---|---|---|---|
| 理想 | 0, 10, 20, 30, 40, 50 | 10 10 10 10 10 → 1 1 1 1 1 |
6 个 token 齐全 |
| 漏检一次 | 30 ms 那次没报出来,只剩 0, 10, 20, 40, 50 | 10 10 20 10 → 1 1 2 1 |
少一个 token(这里是 sat) |
| 多检一次 | 25 ms 处多报一次,变成 0, 10, 20, 25, 30, 40, 50 | 10 10 5 5 10 10 → 1 1 0.5 0.5 1 1 |
混进一个随机 token |
于是两类异常各自有了固定的形状:
- 一个 ≈2 的峰 = 漏检:间隔翻了一倍,说明中间少了一个事件。真阳性原本应该出现在两个相邻命中之间,把它的缺失补回来——预测这个位置的 token 并插进 KD,相当于做完形填空;
- 一对 ≈0.5 的谷 = 多检:假事件插进两个真命中之间,把原本一整个周期切成两段,于是这两段的归一化值都小于 1。原文只给到「小于 1」这一步(Figure 5 里画到 0);上表把假命中放在正中间,所以看到的是 0.5 + 0.5,若它贴着真事件则会出现一个接近 0 的谷。把多出来的那个 token 从 KD 里删掉。
论文把这三选一(补一个、删一个、不动)统一写成序列到序列任务:
1 | O_hat ~ P( O | TD_hat_1, KD_1, TD_hat_2, KD_2, ... ) |
由微调过的 LLMA 实现:输入是时序信号与 token
列表的交替序列,输出是清理后的文本。为什么必须是交替排列,而不是把
TD 与 KD 分开喂? 因为「这里该动」和「该动哪个
token」绑在同一个下标上:TD_hat[k] 说的是「第 k-1
个事件到第 k 个事件这一段间隔不对」,紧挨着它的 KD[k]
才是那个位置上的 token。两样贴在一起,模型才能把「间隔是
2」翻译成「sat 与 the 之间该补一个词」。微调用
LoRA,好处是保留基座模型的先验知识、同时抑制过拟合。(这两个部件各自值多少,见后文消融表:不喂
TD 时输出的 LS 掉 12.7%,去掉 LLMA 只按规则拼 KD 掉 10.3%。)
🧪 训练数据从哪来:合成的
攻击者拿不到受害者的模型和系统,也就没法采集真实数据来训练。但上一节已经把真命中的生成方式讲清楚了:带高斯抖动的周期信号,外加随机删、随机插。既然这套生成规则已经摆在面前,就可以照它反过来造数据,一次都不用碰到受害者(Algorithm 1):
- 从公开语料(UltraChat、NQ-Open、SIQA、SQuAD2、ChatGPT-Roles)取输入输出文本对,组成语料 C;
- 对每个 token
的时间戳按高斯分布累积(
ctime += N(1, σ²)),模拟 TPOT 的自然抖动,得到周期性时序; - 以概率 p 删除事件(制造漏检)、以概率 p 在均匀分布的时间点插入随机 token(制造多检)——「随机 token」正对应假阳性反查出来的那个无关词;
- 把数值的时序信号编码成文本提示,与文本一起组成 (提示, 标准答案)
训练对。编码用的就是上一节那条交替序列:每个条目写成「归一化时间值 :
token」,条目之间用
<s>分隔。例如时序{1.3, 1.2}与 token{Hello, World}编码成1 3:Hello<s>1 2:World<s>(小数点被换成空格,<s>用来分隔相邻的两段),标准答案则是Hello World。
论文在合成数据上把超参数扫了一遍:噪声概率 p 在 10%~40% 的宽范围内性能稳定,超过 50% 才开始下降;周期抖动 σ = 0.08 时最好(σ 太小等于强制严格周期,σ 大于 0.5 则周期性被削弱到模型学不到);基座模型换成开源的 Llama-3.1-8B 或闭源的 GPT-4o-mini 性能差不多,说明这一层的效果主要来自任务本身,而不是某个特定模型。
🔗 还原输入顺序:LLMB
输出文本还原出来之后,还剩输入。输入 token 的集合 KP
已经拿到了,缺的是顺序。论文拿它类比 bag-of-words
模型:词袋丢掉了顺序但保留了语义结构,主题模型(如
LDA)就是这么用的。问题是顺序丢失会伤到句子本身,论文举的例子是
A chased B 与 B chased A——token
集合相同,语义相反。
论文的落点是输入与输出在同一个上下文里相互关联:LLM 常常先把问题复述一遍再回答,所以输入文本对输出文本存在可学习的依赖。于是把任务写成另一个 seq2seq:
1 | I_hat ~ P( I | KP, O_hat ) |
实现方式是微调出 LLMB:把无序的 token 列表编码成
<s>
分隔的文本序列,把已经还原出来的输出文本插在最前面当上下文,让模型推断每个
token 的位置。
训练数据同样靠合成:取语料里的输入 I,把它的 token 顺序随机打乱得到 KP’,再用一个通用 LLM 生成对应的输出 O’,于是 (KP’, O’, I) 就是一条监督样本。
📊 评估:准确到什么程度
实验环境是 Intel 13900K(5.8GHz,BIOS microcode 0x129)+ RTX 3060 12GiB + 32GiB 双通道 DDR4-3200,Ubuntu 22.04 / Linux 5.18.0-38、驱动 525.89.02、CUDA 12.0;微调放在一台 H800 云服务器上。受害模型是 5 个主流 LLM(Gemma2-9B、Llama-3.1-8B、Falcon3-10B、Mistral-7B、Phi-3.5-mini-3B),数据集是 5 个公开语料,合计 212,535 个 token,按 60/20/20 划分训练、验证、测试。
指标分三个粒度:字符级的 Levenshtein 相似度(LS,等于 1 减编辑距离)、token 级的 ROUGE-1 / ROUGE-L、语义级的句向量余弦相似度 φ。为了确定 φ 到多少算泄漏,论文在 Prolific 上招募 100 名参与者,对 50 个样本做人工投票,得出 φ 与隐私暴露程度的线性关系(皮尔逊相关 0.771),取 φ > 0.77 作为攻击成功的判定阈值,ASR 就是超过该阈值的样本比例。
🏁 主结果
论文 Table 1 的汇总行(5 个模型 × 5 个数据集的平均):
| 方向 | 平均长度 | R1 | RL | LS | φ | ASR |
|---|---|---|---|---|---|---|
| 输出还原 | 165 token | 96.3% | 96.3% | 94.8% | 98.7% | 99.1% |
| 输入还原 | 24 token | 89.9% | 85.8% | 82.7% | 98.0% | 99.9% |
对照摘要里的另一组口径:平均编辑距离在输出与输入上分别是 5.2% 与 17.3%。也就是说输出基本可逐字还原,输入能还原语义但字符级有出入。论文对输入侧的差距给了明确解释:输入还原是一个排列问题,搜索空间随输入长度按阶乘增长(约 O(NI!))。
这一点在数据里看得最清楚:
| 数据集 | 平均输入 token 数 | 输入 LS | 备注 |
|---|---|---|---|
| SQuAD2 | 180~209 | 32.2%~34.4% | 长输入,字符级最差 |
| NQ-Open | 12~13 | 79.8%~91.4% | 短输入,还原很好 |
| UltraChat | 19~21 | 84.3%~90.2% | 同上 |
但即使是最差的一格(Phi-3.5-mini on SQuAD2,R1 51.0%、LS 32.2%),余弦相似度仍有 92.1%,ASR 96.4%——语句的主题与语义没有被漏掉。
论文还检查了 prefill 批大小的影响:batch size 从 32 涨到 256,各指标只在 4% 的范围内波动;batch 很小时精度略降,因为合成训练数据假设输入 token 是随机排列的,而小 batch 会让输入分批顺序执行、呈现出更强的顺序性,偏离了训练分布。
🧹 消融:每个部件值多少
| 配置 | 相对完整版的变化 | 说明 |
|---|---|---|
| 去掉时序信号的预处理(一阶差分) | LS −3.0%(输出)/ −1.0%(输入) | 去噪前的归一化有贡献 |
| 完全不喂时序信号 TD | LS −12.7%(输出)/ −1.2%(输入) | token 列表与时序必须融合 |
| 去掉 LLMA,只用 KD 拼文本 | LS −10.3% | 模型去噪比规则去噪值钱 |
| LLMB 去掉还原出的输出上下文 | LS −17.1% | 上下文依赖是输入还原的主要依据 |
| 去掉 LLMB,直接把 KP 当结果 | LS −46.4% | 没有排序模型基本等于没有输入还原 |
还有一组更基础的对照:只用侧信道数据(Pure SCA)时,输入还原只到 R1 50.4%、LS 29.8%、φ 66.1%、ASR 29.3%;加上模型与输出上下文之后是 R1 82.8%、LS 76.2%、φ 96.9%、ASR 99.7%。纯侧信道拿到的是线索,文本还得靠语言模型补全——这也和本文的方法论一致。
🧰 框架与硬件
论文在 10 个主流本地推理框架上验证,CPU 路径全部成功,GPU 路径 9 个成功:
| 维度 | 结果 |
|---|---|
| CPU 推理 | 10 / 10 成功(llama.cpp 的 φ 输出 99.5% / 输入 95.2%) |
| GPU 推理 | 9 / 10 成功,唯一失败的是 HuggingFace Transformers |
| 失败原因 | 它把 embedding 查表放在 GPU 上做,CPU 缓存侧信道探不到 |
| 硬件 | 14900K / 13900K / 12700KF 三台机器,输入还原的 φ 均不低于 96.5%,ASR 100%(该表两栏标号疑似互换,见后文口径一节) |
| 量化 | F16 / Q8_0 / BF16 / F32 四种,φ 在 96.2%~99.3% 之间 |
| 操作系统 | Ubuntu 22.04、Windows 11、Debian 12(Docker 内)均可复现 |
这组结果说明攻击不依赖某个特定框架的实现细节,真正的前提只有一条:embedding 在 CPU 上查表。
💬 真实例子
论文展示的还原样本里,有几个细节很能说明问题:
who played freddy krueger in the 2010 nightmare on elm street?在论文的示例图里三项指标都是 100%。其中 freddy krueger 这类专有名词并没有出现在合成训练集里,模型是从侧信道给出的 token 线索里拼出来的;How can I manage my weight and avoid gaining excess body fat?被还原成How can I manage my weight and avoid excess body fat?:少了一个 gaining,语义不变(φ 98%、R1 96%、LS 87%);what rank is an e5 in the air force?被还原成另一种语序(φ 87%、R1 78%、LS 28%):内容没丢,排列变了;- 失败的例子集中在语义相似度 64%~76%
的区间,典型表现是词序错乱、出现多余的
header、Zoeken这类无关 token——正是噪声污染留下的痕迹。
论文据此指出,这种能力足以窃取 PII(个人身份信息):能还原专有名词、能容忍同义替换与语序变化,语义相似度高而字符相似度偏低,说明泄漏的是内容而不是形式。
📎 读原文时注意的几处口径不一致
精读时我对照了摘要、正文与表格,有几处不一致值得记下来,免得引用时张冠李戴:
| 位置 | 原文写法 | 对照结果 |
|---|---|---|
| 摘要 | cosine similarity 98.7%(input)/ 98.0%(output) | 与正文 §1 和 Table 1 的平均行相反:98.7% 属于输出、98.0% 属于输入 |
| Table 4 | Output Recovery 一栏写作 φI,Input Recovery 一栏写作 φO | 两栏标号疑似互换 |
| §4.4 与 Figure 5 | 正文说 false positive 对应峰、false negative 对应谷;图注写 false positive 在谷、false negative 在峰 | 两处互相矛盾;按语义读才通:峰是漏检(补 token),谷是多检(删 token),此时 Figure 5 的图注与语义一致,正文段落的命名反了 |
| Figure 4 说明 | TPOT 约 10 microseconds,因此在 100Hz 处预期出现峰 | 100Hz 对应每 token 10 毫秒,单位应为 ms |
这类不一致属于原文自身,引用数字时以表格为准。
🛡️ 对策与局限
🚧 论文建议的三种缓解
| 措施 | 做法 | 代价 |
|---|---|---|
| 禁用 zero-copy 加载 | 不让框架用 mmap 映射模型文件,切断共享内存这条路 | llama.cpp 加载耗时增加 17%(整个模型要真拷一遍);同时跑两个以上实例时内存多占约 32% |
| 部署 RBAC | 限制模型文件内存页的共享范围,只允许指定程序共享,可用 eBPF 内核钩子按会话认证 | 现有本地推理框架没有这项能力,需要改造 |
| 硬件隔离缓存 | 用 Intel CAT(Cache Allocation Technology)切分 LLC,把 LLM 与其余进程隔开 | 只有服务器级 Xeon 提供,消费级平台拿不到;而本地 LLM 恰恰主要跑在消费级机器上 |
三条路的共同问题是一样的:缓解手段要么伤性能,要么在目标平台上不存在。这也解释了论文为什么把它当作一个未被防御的现实威胁来报告,而不是一个已被修补的历史漏洞。
🧱 论文承认的边界
- 输入还原的字符级精度不高:受缓存攻击的时间分辨率与 prefill 并行执行限制,长输入的可读性有限;但在接近 6000 字符的长文本上,输入还原的语义 φ 平均仍有 94.8%、ASR 为 99.1%;
- 换用其他 CPU 侧信道有额外门槛:Prime+Probe 一类冲突型攻击只有 set 级空间分辨率,而 embedding table 远大于缓存的路数,一个 set 会映射到多行,候选空间会膨胀;没有共享内存时,ASLR 与不连续的页帧分配还会打乱 set 与行的对应关系,需要额外的运行时画像;
- GPU 侧 embedding 目前打不到:离散 GPU 的缓存与 CPU 不保持一致,需要 GPU 缓存攻击原语(例如 Invalidate+Compare),但那类原语同样有 set 冲突的问题。不过论文也留了一句:NVIDIA 驱动的显存页分配随机性较小、起始地址稳定,反而有利于学习地址映射。
✅ 总结
本地 LLM 的输入输出文本,可以从 CPU 缓存的访问模式里读出来:embedding 查表暴露 token 的值,自回归解码的时序暴露 token 的顺序,剩下的事情交给两个微调过的语言模型去做——一个融合时序与 token 列表去噪还原输出,一个利用输入输出的上下文依赖给乱序的输入 token 排序。
三个值得记住的要点:
- 泄漏点在访存模式上:embedding 是查表而不是乘法,查哪一行是可控的、可观察的;
- 性能优化顺带送出了攻击面:zero-copy 加载是 llama.cpp 这类框架的默认行为,也是攻击者拿到共享内存的捷径;
- 侧信道只是线索,语言模型负责补全:纯侧信道数据的输入还原 ASR 只有 29.3%,加上语言模型与输出上下文后到 99.7%——语义的补全能力本身就是攻击效力的一部分。
如果把这篇和 Hermes Attack 放在一起看,两条路线正好互补:一条站在 CPU 与 GPU 之间的 PCIe 总线上抓明文流量,偷的是模型本身(结构、超参数、权重);另一条站在 CPU 缓存上观察访存模式,偷的是使用模型过程中产生的内容(prompt 与回答)。共性是同一个结论——部署方式决定了数据流经哪些共享硬件,而那些共享硬件才是真正需要加密或隔离的地方。
代码与数据已由作者开源:Zenodo artifact,含攻击实现、Llama-3.1-8B 微调适配器,以及采集到的 cache trace。
🔗 这条路线上还有哪些工作
| 工作 | 来源 | 偷什么 | 入手点 |
|---|---|---|---|
| Hermes Attack | USENIX Security 2021 | 模型本身(结构、超参数、权重) | CPU 与 GPU 之间的 PCIe 明文流量 |
| IKnowWhatYouSaid | USENIX Security 2025 | 输入与输出文本 | CPU 缓存的访存模式 + 时序 |
| LeftoverLocals | Trail of Bits 技术报告 | GPU 显存里的数据残渣 | 同一块 GPU 上未初始化的 local memory |
| Spill The Beans | arXiv 预印本 2505.00817v1 | 输出 token | CPU 缓存里 embedding 表的缓存行 |
(本文为 USENIX Security 2025 论文 I Know What You Said: Unveiling Hardware Cache Side-Channels in Local Large Language Model Inference 的精读笔记,正文表格内的数据取自论文原文。)