LeftoverLocals 精读:从 GPU 显存残渣里偷听本地 LLM 的回复
GPU 里有一块叫 local memory 的高速暂存区,上一个程序用完不擦,下一个程序可以直接把它整块 dump 出来。对于跑在 GPU 上的 LLM,攻击者只要偷到最后一层的输入向量(4 KB),配上从开源模型库匹配到的权重,就能自己算出模型吐出的下一个 token。
论文:LeftoverLocals: Listening to LLM Responses Through Leaked GPU Local Memory(arXiv:2401.16603,2024-01-16 公开披露,CVE-2023-49691)
作者:Tyler Sorensen(Trail of Bits / UC Santa Cruz)、Heidy Khlaaf(Trail of Bits)
同一条思路还有另一种玩法:盯 CPU 缓存,靠访存模式(读了哪一行)加时序(什么时候读的),把这次推理的输入与输出文本整个还原出来(IKnowWhatYouSaid,USENIX Security 2025)。这篇论文走的是相反方向——不碰缓存,捡的是显存里的数据残渣:不需要时序精度,不需要共享内存,也不需要理解受害者用什么算法,只要能在同一块 GPU 上跑自己的程序就行。
📚 基本概念速读
| 名称 | 定义 | 记忆点 |
|---|---|---|
| Local memory | 计算单元内部的一块高速暂存区,由程序自己管理 | CUDA 叫 shared memory,Metal 叫 threadgroup memory,本文用 OpenCL 的叫法 |
| Compute Unit(CU) | GPU 的「核团」,内部有若干执行单元和一块 local memory | NVIDIA 那边叫 SM |
| Kernel | 一次 GPU 调用所执行的函数 | GPU 不在 kernel 之间抢占,所以会「接龙」执行 |
| Workgroup / work-item | kernel 的分组与其中的线程 | 只有同一个 workgroup 共享同一块 local memory |
| Global memory | 显存(或集显用的主存)里的大区域 | 慢,但大 |
| Tiling(分块) | 把大矩阵切成小块分别算,小块放进 local memory 反复复用 | 这就是数据会落在 local memory 的原因 |
| CLBlast | OpenCL 的线性代数库 | llama.cpp 的 OpenCL 后端调它做矩阵运算 |
| Canary | 用来验证泄漏的「标记值」,本文用 123 | 读到了它,就说明读到了别人的数据 |
| 指纹(fingerprint) | 用偷来的权重片段匹配出受害者用的是哪个开源模型 | 攻击的第一步 |
| 输出层 | DNN 的最后一层,形式是「矩阵 × 向量」 | 权重很大、输入向量很小——小的那半刚好能整段偷走 |
🎬 起点:GPU 上「上一个人」留下的东西
先看场景。受害者在自己的笔记本或一台共享服务器上跑本地 LLM,用的是 llama.cpp 这类支持 GPU 加速的框架;同一台机器上还有攻击者的程序——它可能是另一个用户的进程、一个 Docker 容器里的任务,也可能是手机上一个普通 App。
论文的威胁模型只有两条:
- 攻击者能在共享的 GPU 上跑计算任务,比如通过 OpenCL、Vulkan、Metal 写一个 GPU 程序。这些框架都是常规能力,不需要管理员权限;
- 攻击者与受害者同时在用同一块 GPU,而且攻击者的 kernel 有机会排在受害者的 kernel 后面执行。
满足这两条之后,攻击者要做的只有一件事:把自己的 GPU kernel 里那块没初始化的 local memory 读出来。论文给出的 listener kernel 不到十行代码(见下文),而且不需要知道受害者跑的是什么模型、什么框架、什么算法。
这里和 CPU 侧信道有个本质区别值得一提:
| CPU 缓存路线(IKnowWhatYouSaid) | 显存残渣路线(本篇) | |
|---|---|---|
| 偷的是 | 访存模式与时序 | 内存里的内容本身 |
| 需要什么 | 共享内存 + 精确计时 + 猜算法 | 只要能跑 GPU 程序 |
| 精度 | 要重建、去噪、猜 | 直接就是原始数据 |
| 难度 | 需要一套信号处理管线 | 十行 kernel |
🧠 local memory 是什么,为什么它会「留下东西」
GPU 的结构是分层的:顶上一层是若干个 Compute Unit,每个 CU 里面有执行单元和一块专属于自己的高速暂存区,这块暂存区就是 local memory。
1 | GPU |
它有几个关键性质,全都和这个漏洞有关:
- 容量小、速度快:每块 CU 16 KB 到 64 KB,访问延迟远低于显存,所以它是 GPU 程序员做性能优化的第一件工具;
- 由程序自己管理:它不是硬件自动帮你缓存的(不像 CPU 缓存),而是程序显式地把「接下来要反复用」的数据搬进去,所以论文叫它「软件管理的缓存」;
- 只在同一个 workgroup 内共享:不同 workgroup 之间的 local memory 是相互独立的;
- 分配发生在 kernel 启动时,但规范没有要求跨 kernel 清零。
最后一条就是这个漏洞的全部来源。用个比方:local memory 像一块白板,每个 GPU 程序上来写完、用完就走,而下一个程序上来时,白板上还留着上一个人的字迹——它没有擦。
更巧的是,GPU 通常不在 kernel 之间做抢占式调度:如果多个进程同时提交了 kernel,GPU 会把一个跑完再跑下一个。这个设计本来是为了省掉昂贵的抢占开销(GPU kernel 一般都很短),但它顺手变成了攻击的便利条件——攻击者的 kernel 只要排上队,就一定能读到「上一位」留下的东西。
1 | Victim kernel 运行 |
🕵️ 攻击本体:不到十行的 kernel
论文用两个小程序把漏洞演示清楚:一个叫 listener(攻击者),一个叫 writer(受害者)。
listener 的逻辑就是「把没初始化的 local memory 倒出来」:
1 | __kernel void listener(__global volatile int *dump) |
几处细节值得留意:
lm声明后没有赋初值,读它就是读「上一个人留下的内容」——这在语言层面属于未定义行为(undefined behavior),但没有工具会检查或记录它;- 加
volatile是为了防止编译器看出「这段内存没人用」而把访问优化掉;论文说这是靠试错调出来的,还额外加了几个模式来阻止优化; - 索引部分稍绕,是因为 local memory 在不同 workgroup 之间是互相独立的,需要把 group 内的编号映射成显存里的唯一位置;
- 最后
dump在显存里,拷回 CPU 就能看了。
writer 更简单,只是往 local memory 里写一个标记值(论文用
123)。测试时让 writer 和 listener
反复交替执行,只要 listener 能稳定读到 123,就说明这个平台存在
LeftoverLocals。
注意 writer 是「假想中的受害者」:把它换成真正的 LLM,写进去的就是会话的中间结果——而读它的那个短 kernel,一个字都不用改。
这件事还有个让人不舒服的地方:很隐蔽。listener kernel 本身很短,可以反复、持续地跑,论文说它的性能影响小到「几乎没有可察觉的下降」;受害者那边既不报错,也没有任何日志。
🎯 偷听 LLM 会话:两步走
第一步:给模型打指纹(顺手拿到 80 MB 权重)
LLM 的每一层都要做矩阵乘法,而 GPU 上的矩阵乘法几乎都用了 tiling:把大矩阵切成小块,小块放进 local memory 反复复用。于是每算一层,local memory 里同时躺着这一层的权重分块和输入分块。
在论文的实验平台上,一块 AMD Radeon RX 7900 XT 有 84 个 CU、每 CU 64 KB,local memory 总量约 5 MB。攻击者一次能读到多少呢?
- 每一次 GPU 调用泄漏约 5.5 MB;
- 每一层里,约 2.5 MB 是权重、2.5 MB 是输入;
- 模型有 33 层,所以整次推理累计能偷到约 80 MB 的权重(33 × 2.5 MB)。
80 MB 听起来不多——很多层的完整权重动辄上百 MB。但它的用途不是「拼出模型」,而是认出模型:拿这些权重片段去比对公开的模型库(比如 Hugging Face),只要匹配上,攻击者就拿到了完整的权重。论文明确说,这一步依赖一个前提:受害者用的是开源模型。
第二步:偷最后一层的输入向量(只要 4 KB)
模型的最后一层是矩阵 × 向量乘:一边是权重矩阵,另一边是「这一层的输入向量」——后者是用户输入经过前面所有层传播后得到的值,它就是模型即将用它决定下一个 token 的东西。
这一层的两种数据量差距极大:
| 数据 | 大小 | 攻击者需要偷吗 |
|---|---|---|
| 输出层的权重矩阵 | 约 128 MB | 不用偷——第一步的指纹已经提供了完整权重 |
| 输出层的输入向量 | 约 4 KB | 要偷,而且能完整偷到 |
为什么能完整偷到?因为矩阵-向量乘的最优实现恰好就是「把那个小向量整段放进 local memory」——它要被反复取用来做内积。于是这一小段数据全程躺在 local memory 里,等着被 dump。
怎么在乱七八糟的残渣里认出它?论文给出的判据朴素得出奇:找一段 4 KB 的浮点数,两边都是 0。作者说这个特征「几乎每一次」都能命中输出层(换个模型、换个 GPU 可能需要重新校准)。
拿到权重和输入向量之后,攻击者在自己机器上做一次矩阵×向量乘,就得到了模型的输出 token:
1 | 第一步 反复 dump local memory |
📊 偷到的内容长什么样
论文开头放了一张对照截图:左边是受害者的终端(黑底),右边是攻击者一边偷一边重建出来的文本(白底)。
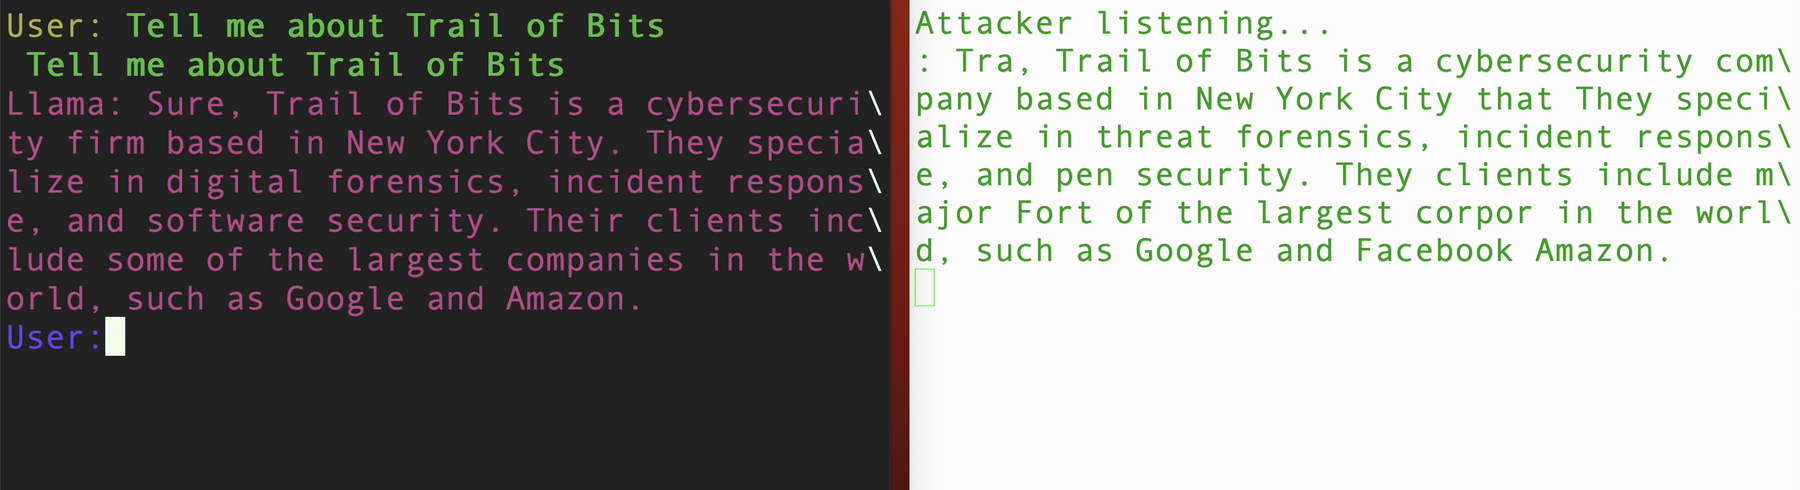
从这张图能看到一个关键事实:攻击者拿到的文本不是「隐约像」,而是能读的句子,尽管中间会夹着一些错字。
论文把攻击产出的错误归成四类,这四类的成因很能说明攻击的边界:
| 伪影 | 现象 | 成因 |
|---|---|---|
| 重复 token | 同一个 token 出现两次 | 攻击者连续被调度两次,而受害者还没算下一个 token |
| 缺失 token | 少了一个 token | 攻击者的 kernel 没排在输出层 kernel 的紧跟后面 |
| 错误 token | 蹦出一个毫不相干的词 | 把某段数据误判成了输出层 |
| 相似 token | 意思接近但词不对 | 偷到的向量不精确,解码后落在语义相近的位置 |
最后一类是最好玩的例子:论文的截图里攻击者把某个命名实体读成了 Facebook,而原文那个位置是 Google、Amazon 这类词——在词向量的意义上是邻居。这说明攻击者拿到的东西已经足够接近真实值,只是在解码时落到了隔壁。
🧪 测过哪些 GPU
作者写了四套测试程序(Vulkan 命令行、OpenCL 命令行、iOS/macOS App、Android App),在 11 台设备、7 个厂商上做了测试,结论如下。
| 结果 | 设备 |
|---|---|
| 受影响(读到别的进程的数据) | Apple iPhone 12 Pro(A14)、iPad Air 3(A12)、MacBook Air(M2)、AMD Radeon RX 7900 XT(Vulkan 与 OpenCL 两种)、AMD Ryzen 7 5700G 集显、AMD RX 6700 XT、一加 11(骁龙 8 Gen 2)、一加 5T(骁龙 835) |
| 读到非零数据,但无法确认来自其他进程 | Arm Mali G78 / G71 / G710(Arm 方面复核后确认不是内存泄漏) |
| 未观测到(local memory 里只有 0) | NVIDIA RTX 4070、Intel NUC、Imagination PowerVR GE8320 |
几条值得记下的结论:
- 泄漏量和 GPU 大小成正比:卡的 local memory 总量越大,一次能倒出来的数据越多。大独显(RX 7900 XT)单次 kernel 就能泄漏 5 MB 以上;
- NVIDIA 这次没被卷进来,论文的猜测是前人早就披露过类似的 CUDA 显存泄漏问题,所以他们提前处理了;
- Imagination 是个回旋镖:作者在自己的设备上没测出来,但 Google 后来告诉他们,其他 Imagination GPU 确实受影响(厂商随后在 DDK 23.3 里修了)。
至于攻击在哪些环境里能落地,论文的讨论比结论更谨慎:
- 多用户服务器、桌面系统、Docker 容器:作者确实在这些环境里复现了。只要是同一台机器上的不同进程,就成立;
- 公有云:AWS、Azure 这类一般不会把一块物理 GPU 共享给不同用户;即使用 NVIDIA vGPU、AMD MxGPU 这类虚拟化技术,也会把 GPU 物理切分,local memory 跟着被切开。所以很多当前的云 GPU 环境可能并不受影响——但论文强调,他们对这些系统的实现细节了解有限,不能下确定结论;
- 手机:iOS/Android 上很难让一个 App 在后台持续跑 GPU 任务,所以「恶意 App 在后台偷听」这种场景受限;但两个 App 并排、或者快速切换前后台,是可以生效的(论文附了演示视频);
- 浏览器:WebGPU 会给 local memory 做初始化和动态边界检查,因此在受影响设备上也只能读到 0。作者补了一句:这些检查开销不小,而且「GPU 编译器很脆弱」,绕过检查的编译器 bug 并不是不可想象——他们的立场是在驱动层解决,而不是靠上层框架兜底。
🛡️ 为什么这个漏洞难修
先看一个反直觉的发现:有些驱动其实已经在清零了,但没用。
Mesa 为 AMD GPU 提供的驱动,在每次计算 kernel 结束后确实会清空 local memory。问题在于,这次清零是用另一个独立的 kernel 完成的。于是 GPU 的 kernel 队列可以长成这样:
1 | 受害者的计算 kernel → 攻击者的 listener kernel → 驱动的清零 kernel |
要真正修掉这个问题,「清零」必须和「计算」原子地绑定在一起——中间不允许插入任何其他 kernel。
那用户能不能自己防御?可以,但要改所有用到 local memory 的 kernel:在
kernel 结束前把用过的位置写 0,而且要用 volatile
之类的写法防止编译器把「没人读的清零」优化掉。
论文对这条路的态度是「理论上可行,实践上很难」:GPU 代码往往藏在层层软件栈底下——LLM 的矩阵运算在 CLBlast 这类高度优化的库内部,用户既看不见它用了 local memory,也很难去改它。何况 GPU 二进制通常不像 CPU 那样落盘保存,可以做分析的工具也很少。
再往上,作者引了 Vulkan 规范里的一段话,说明了这件事本来就不该发生:
任何由操作系统提供的、关于「一个进程的内存能否被另一个进程看到」的保证,都不能被 Vulkan 实现所违反。
而这次被点名的几个平台,恰恰违反了这个要求。
📎 读这篇时要注意的几点
这篇论文有几处性质与口径需要先分清楚,免得引用时出错:
| 位置 | 需要注意的地方 |
|---|---|
| 它是什么 | 这不是会议论文,而是 Trail of Bits 博文的技术报告版本——作者在 §1 明说本文是官方博客文章的「直接移植」(direct port),写成文档只是为了便于归档与引用。引用时按技术报告处理,别当成同行评审论文 |
| 厂商状态是快照 | 论文里各厂商的处置状态标注的是 2024-02-01 前后的情况(Apple 的 A17/M3 已修但 M2 MacBook Air 仍受影响、Qualcomm 固件 v2.073 修了部分设备、Imagination 在 DDK 23.3 修复)。这些状态会随时间变化 |
| PoC 动了代码 | 论文 §5 承认,llama.cpp 当时的矩阵-向量乘实现「不够地道」,他们把这一处替换成了自己的实现。所以「拿原版 llama.cpp 开箱即用就能偷」并不成立,攻击依赖于优化过的实现 |
| 只验证了输出 | 论文的 LLM 攻击只演示了输出侧的重建,没有涉及输入(prompt)的重建 |
| 两个数字的含义不同 | 5.5 MB 是一次 GPU 调用的泄漏量,181 MB 是一次 LLM 查询的累计泄漏量。另外顺手算一下:181 ÷ 5.5 ≈ 33,正好等于实验模型的层数——这个除法是我们自己做的,原文并没有把两者点破 |
| 泄漏量取决于硬件 | 所有具体数字都来自 AMD Radeon RX 7900 XT(84 CU × 64 KB ≈ 5 MB local memory)与 wizardLM-7B 这个组合,换模型、换卡都要重新标定 |
✅ 总结
同一块 GPU 上的另一个进程,可以把上一个 kernel 留在 local memory 里的数据整块读出来;对 LLM 而言,这份残渣里最值钱的是最后一层的输入向量——它小到能被完整偷走,而得到它就等于得到模型的输出 token。
三个可以带走的要点:
- 泄漏源的层次又往下走了一层。CPU 缓存那条路线泄漏在访问模式上,这条路线泄漏在 GPU 显存的内容上——前者需要一套信号处理管线去重建,后者是原始数据直接倒出来;
- 「开销优化」再一次变成了攻击面。local memory 是为了性能才被用起来的(tiling、复用小数据),GPU 不在 kernel 之间抢占也是为了性能——两个设计凑在一起,就构成了这个漏洞;
- 最难修的地方在于「原子性」。Mesa 已经在清零了,但清零和计算之间存在一个可以被插入的缝隙;只要这个缝隙还在,任何「分两步做」的防御都会被同样的手法绕过。
把两条路线放在一起看,本地 LLM 的部署正在被从两个方向同时拆解:CPU 侧从访存模式里还原文本,GPU 侧直接从显存残渣里把数据捞走。共同的前提也是一样的——你的数据没有离开这台机器,但它经过了共享的硬件,而共享硬件才是真正需要对它负责的地方。
🔗 这条路线上还有哪些工作
| 工作 | 来源 | 偷什么 | 入手点 |
|---|---|---|---|
| Hermes Attack | USENIX Security 2021 | 模型本身(结构、超参数、权重) | CPU 与 GPU 之间的 PCIe 明文流量 |
| IKnowWhatYouSaid | USENIX Security 2025 | 输入与输出文本 | CPU 缓存的访存模式 + 时序 |
| LeftoverLocals | Trail of Bits 技术报告 | GPU 显存里的数据残渣 | 同一块 GPU 上未初始化的 local memory |
| Spill The Beans | arXiv 预印本 2505.00817v1 | 输出 token | CPU 缓存里 embedding 表的缓存行 |